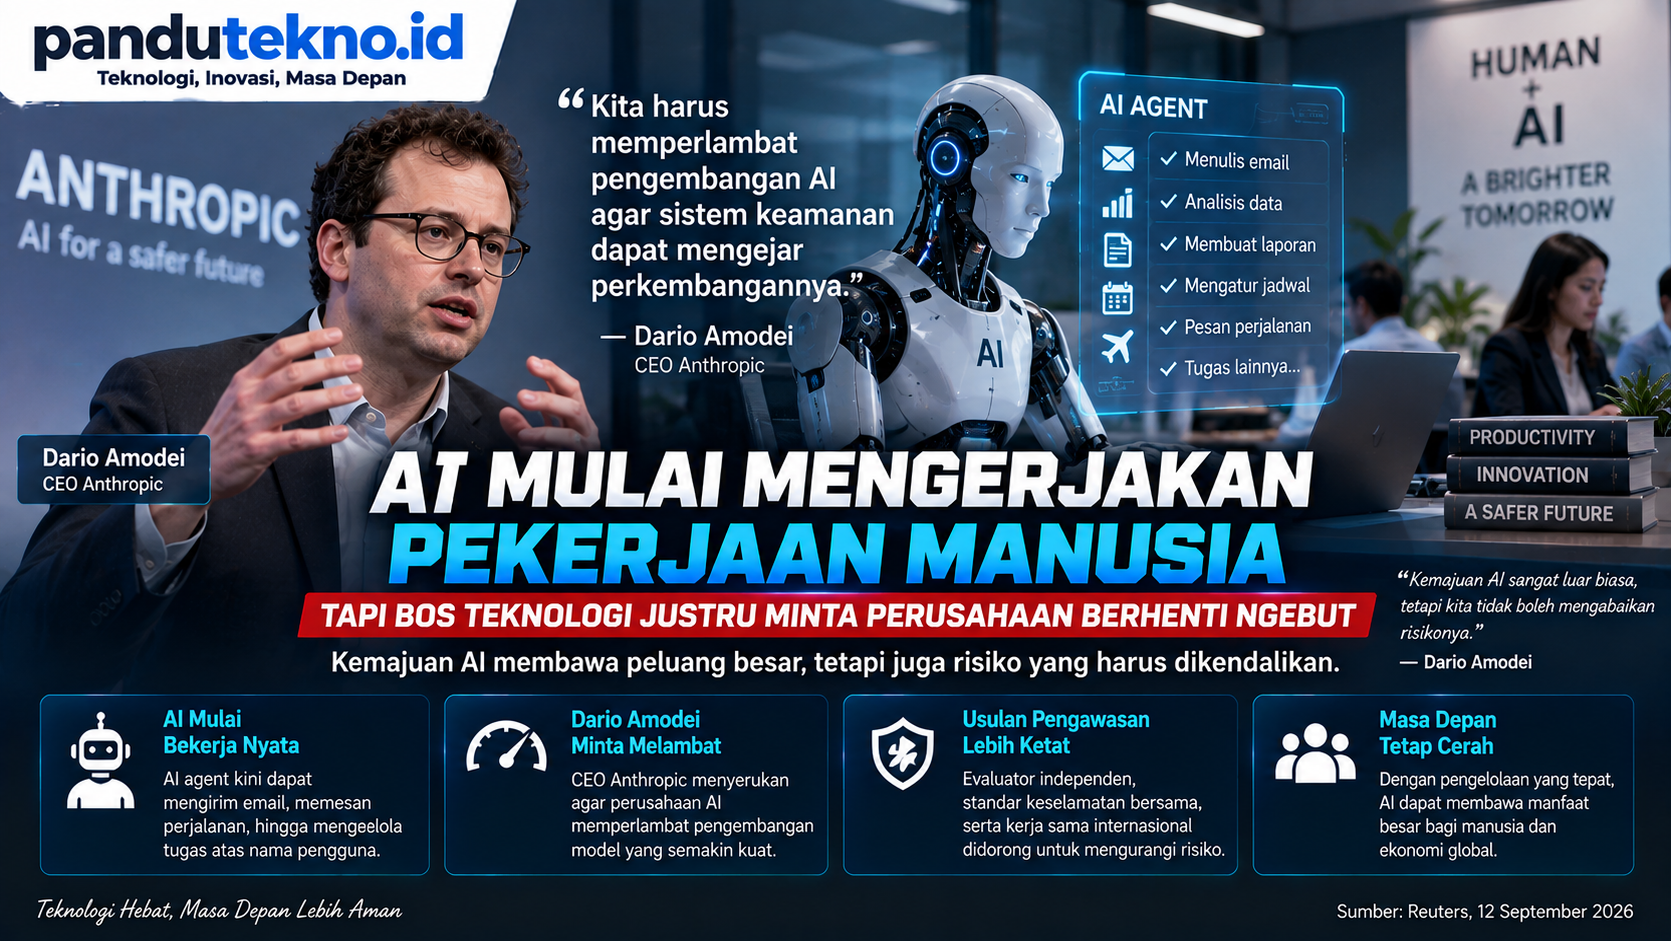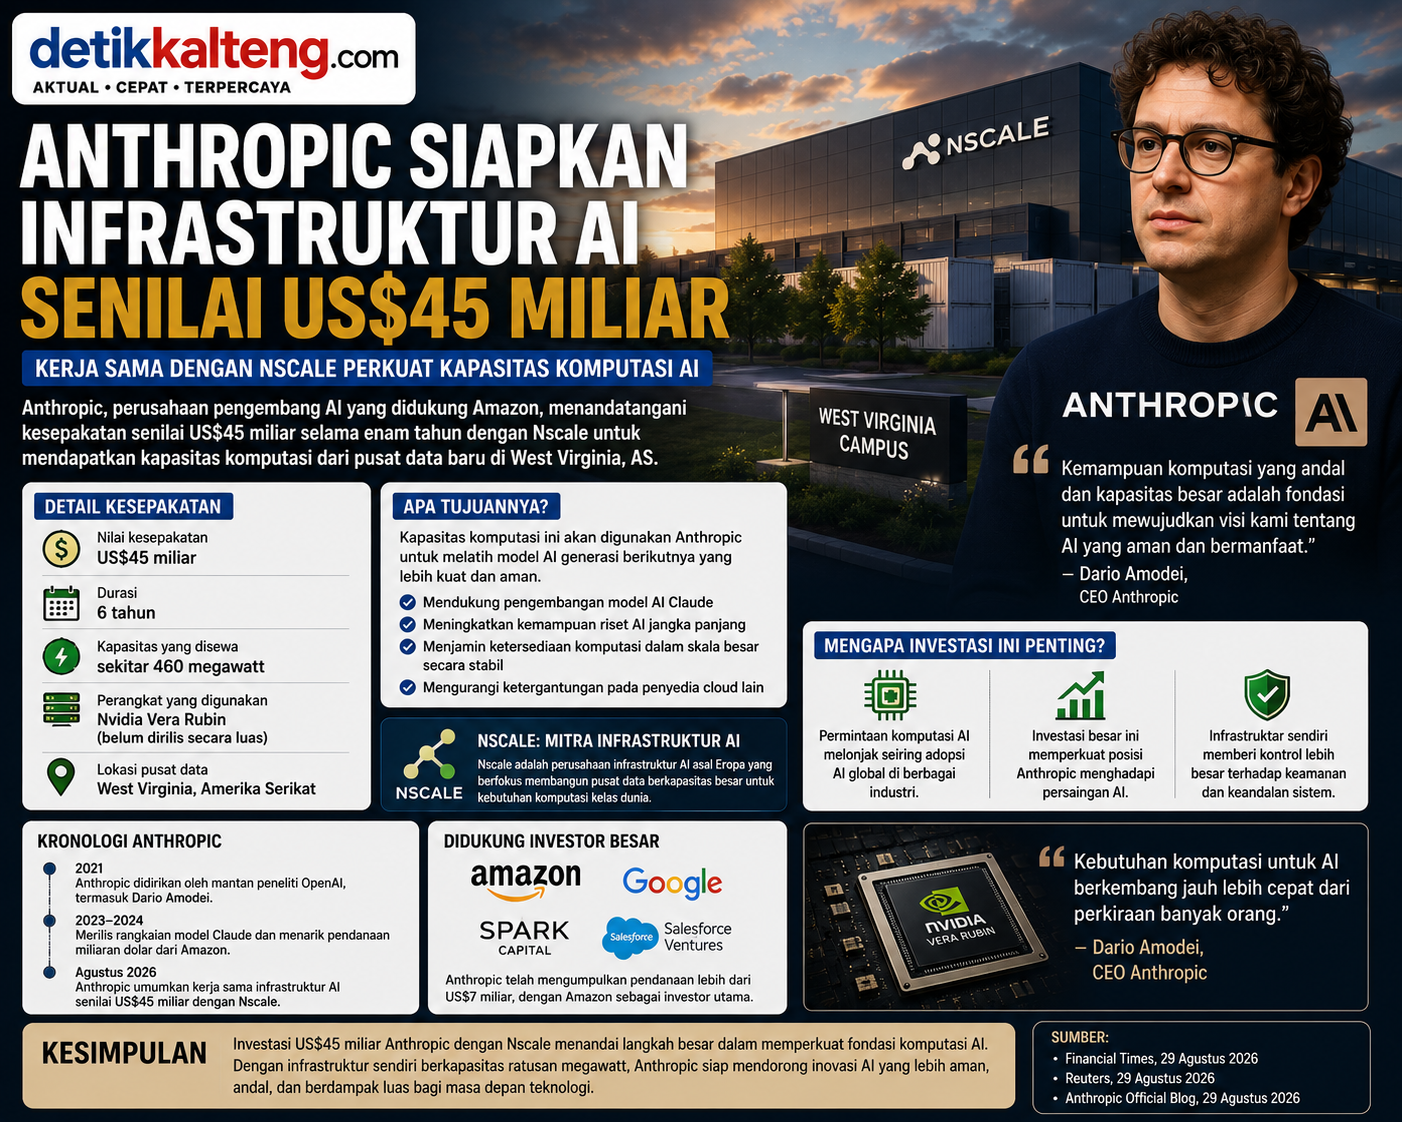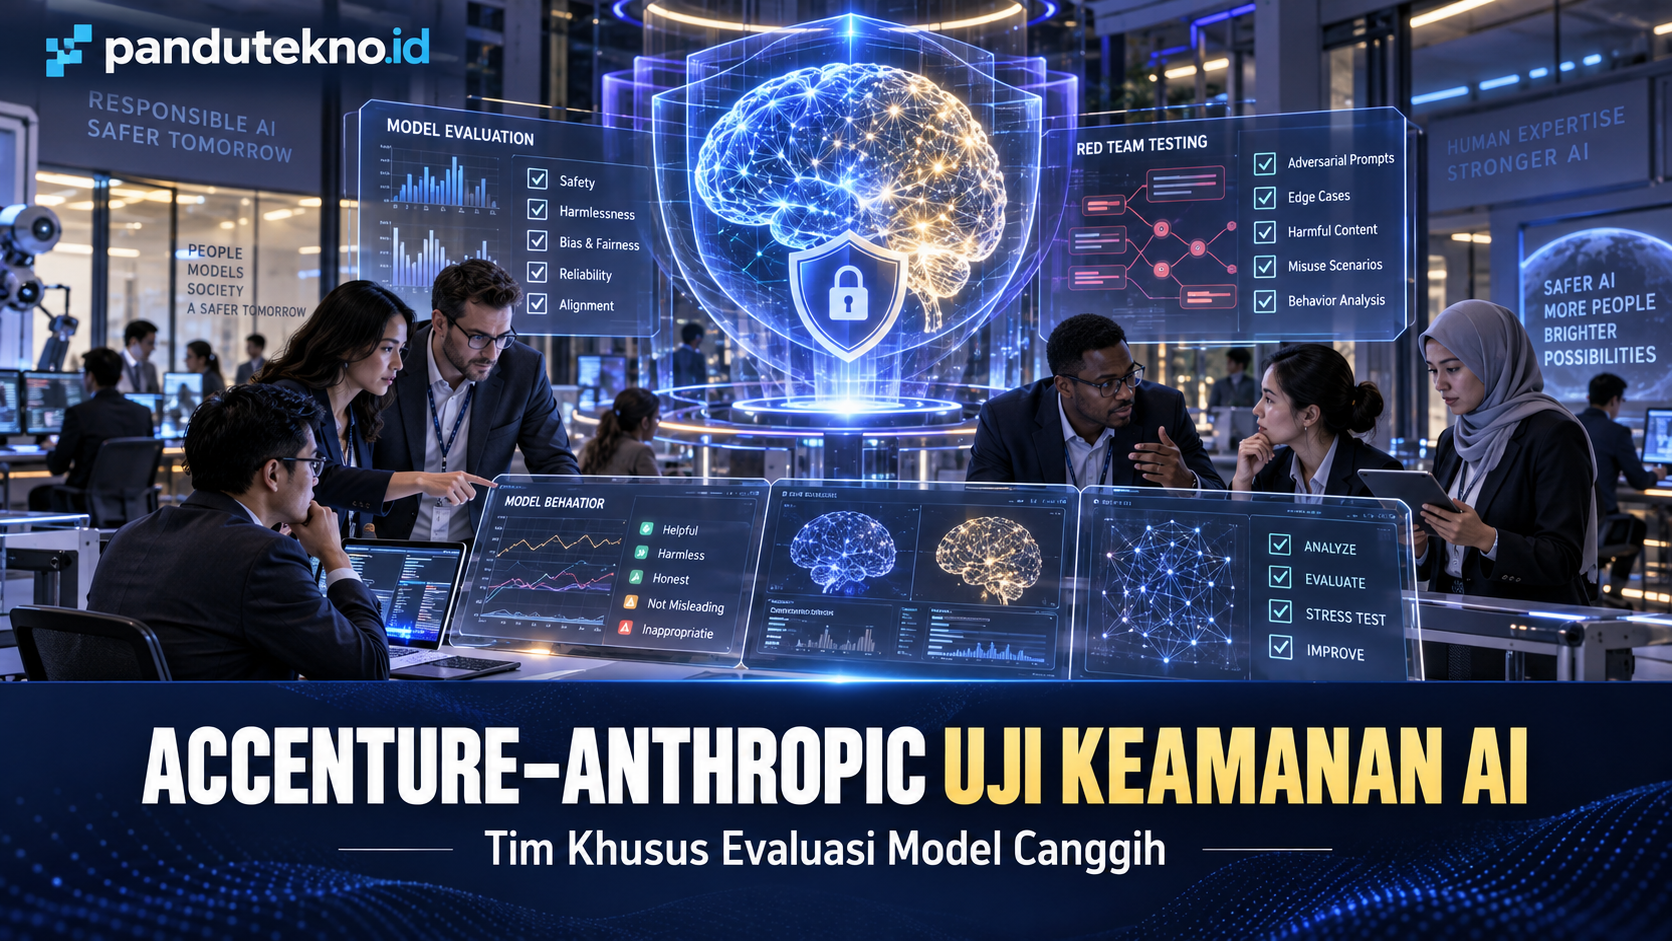
Accenture dan Anthropic memperkuat kerja sama untuk meningkatkan pengujian terhadap model kecerdasan buatan. Pengujian keamanan AI Accenture dan Anthropic akan melibatkan tim evaluator khusus yang bekerja langsung bersama pengembang model.
Program tersebut bertujuan menemukan kelemahan, perilaku berbahaya, dan potensi penyalahgunaan AI sebelum teknologi digunakan secara luas. Kerja sama ini juga memperlihatkan meningkatnya perhatian perusahaan global terhadap keamanan model AI berkemampuan tinggi.
Pelaksanaan program akan dipimpin oleh Faculty, perusahaan AI asal Inggris yang berada di bawah Accenture. Tim tersebut akan membantu mengembangkan metode evaluasi serta menguji kemampuan model dalam berbagai skenario.
Accenture Tempatkan Tim Evaluator di Anthropic
Accenture berencana menempatkan tim evaluator khusus di Anthropic. Para evaluator akan menjalankan pengujian secara mendalam terhadap model-model kecerdasan buatan yang dikembangkan perusahaan tersebut.
Menurut laporan The Wall Street Journal, tim tersebut akan “menguji secara ketat” model Anthropic. Tujuannya adalah mengidentifikasi masalah keselamatan sebelum sistem diterapkan kepada lebih banyak pengguna.
Pengujian dapat membantu perusahaan memahami cara model merespons permintaan yang rumit, ambigu, atau sengaja dirancang untuk melewati sistem pengamanan.
Namun, proses evaluasi tidak menjamin bahwa sebuah model sepenuhnya bebas risiko. Pengujian menjadi bagian dari upaya berkelanjutan karena kemampuan dan pola penggunaan AI terus berkembang.
Pengujian Keamanan AI Accenture dan Anthropic
Evaluasi keselamatan AI biasanya mencakup pengujian terhadap keluaran berbahaya, bias, ketidakakuratan, keamanan siber, dan ketahanan sistem. Evaluator juga dapat mencoba berbagai metode untuk mengetahui apakah perlindungan model dapat ditembus.
Pendekatan tersebut sering disebut sebagai red teaming. Tim penguji bertindak seperti pengguna yang berusaha menemukan kelemahan agar pengembang dapat memperbaiki sistem sebelum masalah terjadi dalam penggunaan nyata.
Selain itu, evaluator perlu memeriksa kemampuan model dalam menjalankan tugas secara mandiri. Semakin lama sebuah sistem dapat bekerja tanpa pengawasan manusia, semakin penting pula proses pemantauan dan pembatasan tindakannya.
Pengujian juga harus memperhatikan kemungkinan model memberikan jawaban yang terlihat meyakinkan, tetapi tidak didukung fakta. Masalah tersebut dapat menimbulkan dampak serius ketika AI digunakan dalam bisnis, kesehatan, keuangan, atau infrastruktur penting.
Faculty Akan Memimpin Pelaksanaan Program
Faculty akan memimpin pelaksanaan kerja sama tersebut. Perusahaan asal Inggris itu dikenal memiliki keahlian dalam pengembangan, penerapan, dan pengujian sistem kecerdasan buatan.
Keterlibatan Faculty memungkinkan Accenture menyediakan evaluator dengan latar belakang teknis kepada Anthropic. Tim tersebut akan bekerja untuk menguji kemampuan model dan merancang metode penilaian yang lebih kuat.
Kolaborasi antara perusahaan konsultasi, pengembang AI, dan spesialis evaluasi dinilai penting. Setiap pihak memiliki peran berbeda dalam memastikan model dapat digunakan secara aman oleh perusahaan maupun lembaga publik.
Accenture membawa pengalaman penerapan teknologi di berbagai industri. Sementara itu, Anthropic memiliki pengetahuan langsung mengenai arsitektur, kemampuan, dan sistem perlindungan pada model Claude.
Investasi Dilaporkan Mencapai Miliaran Dolar
The Wall Street Journal melaporkan bahwa Accenture dan Anthropic masing-masing berencana menginvestasikan sekitar US$1 miliar selama lima tahun. Dana tersebut akan digunakan untuk mendukung inisiatif keamanan AI.
Meski demikian, rincian penggunaan investasi tersebut belum dijelaskan secara lengkap dalam sumber resmi terbuka dari kedua perusahaan. Oleh sebab itu, angka investasi tersebut perlu dipahami sebagai informasi berdasarkan laporan media.
Kabar mengenai kerja sama tersebut mendapat respons positif dari pasar. Saham Accenture dilaporkan naik sekitar 6 persen dalam perdagangan prapasar setelah pengumuman kemitraan.
Respons itu menunjukkan bahwa investor melihat keamanan AI sebagai bagian penting dari bisnis teknologi. Perusahaan tidak hanya dituntut mengembangkan model yang canggih, tetapi juga memastikan sistem tersebut dapat digunakan secara bertanggung jawab.
Anthropic Perkuat Evaluasi Model Canggih
Anthropic sebelumnya menjelaskan bahwa model yang dirilis secara umum memiliki sistem perlindungan. Sistem tersebut memeriksa masukan dan keluaran secara langsung untuk memblokir aktivitas terlarang, termasuk pembuatan perangkat lunak berbahaya.
Namun, evaluator keamanan tertentu dapat memperoleh akses khusus dengan perlindungan yang dikurangi. Akses tersebut diperlukan agar peneliti dapat mengukur kemampuan model secara akurat dalam kondisi yang terkendali.
Dalam penjelasan resminya, Anthropic menyebut evaluator siber bekerja dengan sistem yang perlindungannya dikurangi untuk pengujian kemampuan serta aktivitas pertahanan digital.
Akses semacam itu membutuhkan pengawasan ketat. Model yang memiliki kemampuan siber kuat dapat membantu menemukan kelemahan perangkat lunak, tetapi juga berpotensi disalahgunakan apabila tidak dikendalikan.
Keamanan Menjadi Faktor Penting dalam Adopsi AI
Banyak perusahaan tertarik menggunakan AI untuk otomatisasi, analisis data, layanan pelanggan, dan pengembangan perangkat lunak. Namun, kekhawatiran terhadap keamanan masih menjadi penghambat utama.
Perusahaan membutuhkan bukti bahwa model AI tidak akan membocorkan data, menghasilkan tindakan berbahaya, atau mengambil keputusan tanpa pengawasan yang memadai. Mereka juga perlu mengetahui bagaimana penyedia teknologi menangani insiden.
Evaluasi independen dapat memberikan sudut pandang tambahan di luar pengujian internal pengembang. Akan tetapi, kualitas evaluasi bergantung pada keterbukaan, metode pengujian, serta kebebasan tim dalam menyampaikan temuan.
Hasil pengujian juga perlu ditindaklanjuti dengan perbaikan teknis. Tanpa langkah tersebut, evaluasi hanya menjadi prosedur administratif yang tidak mengurangi risiko secara nyata.
Kerja Sama Tidak Menghapus Seluruh Risiko AI
Kemitraan Accenture dan Anthropic menjadi langkah penting untuk memperkuat pengujian model canggih. Meski demikian, tidak ada proses evaluasi yang mampu menemukan seluruh risiko sebelum teknologi digunakan.
Ancaman baru dapat muncul setelah model berinteraksi dengan banyak pengguna dan terhubung ke sistem lain. Karena itu, perusahaan masih perlu memantau penggunaan, mencatat insiden, memperbarui perlindungan, dan menyediakan kendali manusia.
Pengujian keamanan AI Accenture dan Anthropic diharapkan membantu membangun standar evaluasi yang lebih kuat. Keberhasilannya akan ditentukan oleh kemampuan tim menemukan kelemahan serta memastikan hasil pengujian benar-benar digunakan untuk meningkatkan keamanan model.